80 % des agents IA dérivent en silence. Les 8 KPIs qui changent ça
Mardi 14h. Vous avez déployé un agent IA il y a trois mois. Il tourne. Vous ouvrez votre tableur de suivi : trois colonnes mises à jour à la main, dernière maj il y a trois semaines. Vous ne savez pas vraiment s’il fonctionne. Vous avez peur de le couper, peur de l’étendre. Cette zone grise a un nom : c’est là que 60 à 80 % des projets IA viennent mourir.
Lundi matin, trois mois après le déploiement
Selon une étude RAND reprise par Gartner, 80,3 % des projets IA échouent à délivrer la valeur attendue. Le taux d’abandon des pilotes GenAI atteint 95 %, contre 34 % pour l’IA traditionnelle. La cause n°1 n’est ni le modèle ni le budget : c’est l’absence d’instrumentation.
Le schéma se répète. Un agent est lancé en grande pompe (tri d’emails, qualification de leads entrants, peu importe le cas), il tourne, l’équipe est enthousiaste. Puis l’attention retombe. Trois mois plus tard, personne ne sait dire combien coûte chaque interaction ni si la qualité a baissé. L’agent est devenu un objet de foi.
La vraie question n’est pas « mon agent fonctionne-t-il ? ». C’est : est-ce que je sais répondre à cette question ?
Le piège silencieux : deflection n’est pas résolution
Beaucoup de PME se félicitent d’un taux de « deflection » à 90 % : la conversation s’est terminée sans escalader. Sauf que la deflection mesure une absence, pas un résultat. Un agent peut afficher 90 % de deflection et seulement 40 % de vraie résolution. L’utilisateur abandonne ou rappelle plus tard sur un autre canal.
La nuance, bien décrite par Lorikeet, est critique. Deflection = la conversation n’a pas escaladé. Résolution = le problème est vraiment réglé. Mesurer la première sans la seconde, c’est piloter votre voiture sans regarder la jauge d’essence.
Guide gratuit
Le Guide du Site Web pour PME
Un guide pour comprendre les choix techniques, les pièges à éviter et les critères de sélection d'un prestataire web.
Recevoir le guide gratuitementTrois familles de KPIs, pas une seule
On ne mesure pas un agent IA comme un site web. Il faut trois familles complémentaires.
Business : Est-ce que ça crée de la valeur ? Résolution autonome, coût par interaction, temps humain économisé, delta CSAT.
Opérationnel : Est-ce que ça tient la route ? Escalade humaine, taux d’erreur, latence p95.
Qualité IA : Est-ce que ça dérive ? Drift (le comportement change sans qu’on l’ait demandé), taux d’hallucination.
Le secret : ne pas tout mesurer. Huit KPIs bien choisis battent vingt-cinq KPIs jamais regardés.
Les 8 KPIs essentiels
Famille business
1. Le taux de résolution autonome
(Interactions résolues sans humain ÷ Total) × 100. Seuil d’alerte : moins de 25 %. Revue hebdomadaire. Owner : ops. Production attendue : 30 à 55 % pour un agent bien configuré, selon Fin.ai.
2. Le coût par interaction
(Inference + monitoring + infra + support) ÷ Interactions. Seuil : plus de 50 % du coût humain équivalent. Revue mensuelle. Owner : finance. Benchmark : ticket humain 6 à 12 €, résolution IA optimisée 1 à 2 €.
3. Le gain de temps humain
Interactions automatisées × Temps humain équivalent. Seuil : moins de 70 % de la projection initiale. Revue mensuelle. Owner : ops. Compter les heures réellement libérées, pas théoriques.
4. Le delta CSAT
CSAT post-déploiement − CSAT baseline. Seuil : delta négatif supérieur à 5 points. Revue mensuelle. Owner : qualité. Un recul de 8 points = votre agent vous fait perdre des clients silencieusement.
Famille opérationnelle
5. Le taux d’escalade humaine
Escalades ÷ Total × 100. Seuil : plus de 40 %. Revue hebdomadaire. Owner : ops. Une escalade élevée signale un cas d’usage trop ambitieux ou une base de connaissances incomplète.
6. Le taux d’erreur
(Mauvaises réponses + mauvaises actions) ÷ Total × 100. Seuil : plus de 5 %. Revue hebdomadaire. Owner : tech lead. Nécessite un échantillonnage qualité manuel, sans humain qui regarde, vous ne saurez jamais.
7. La latence p95
Le 95ᵉ percentile du temps de réponse. Seuil : plus de 5 secondes en conversationnel, plus de 30 secondes en asynchrone. Revue quotidienne. Owner : tech. Détecte les régressions silencieuses (modèle qui ralentit, base vectorielle qui grossit).
Famille qualité IA
8. Le drift et l’hallucination
Drift : variation statistique entre la distribution actuelle et la baseline (indicateur PSI). Hallucination : réponses non ancrées dans une source vérifiable. Seuils : PSI supérieur à 0,25, hallucination supérieure à 2 %. Revue mensuelle pour le drift, hebdomadaire pour les hallucinations. Owner : tech ou ML ops. Ces dimensions font partie du framework CLAW-10 d’évaluation continue.
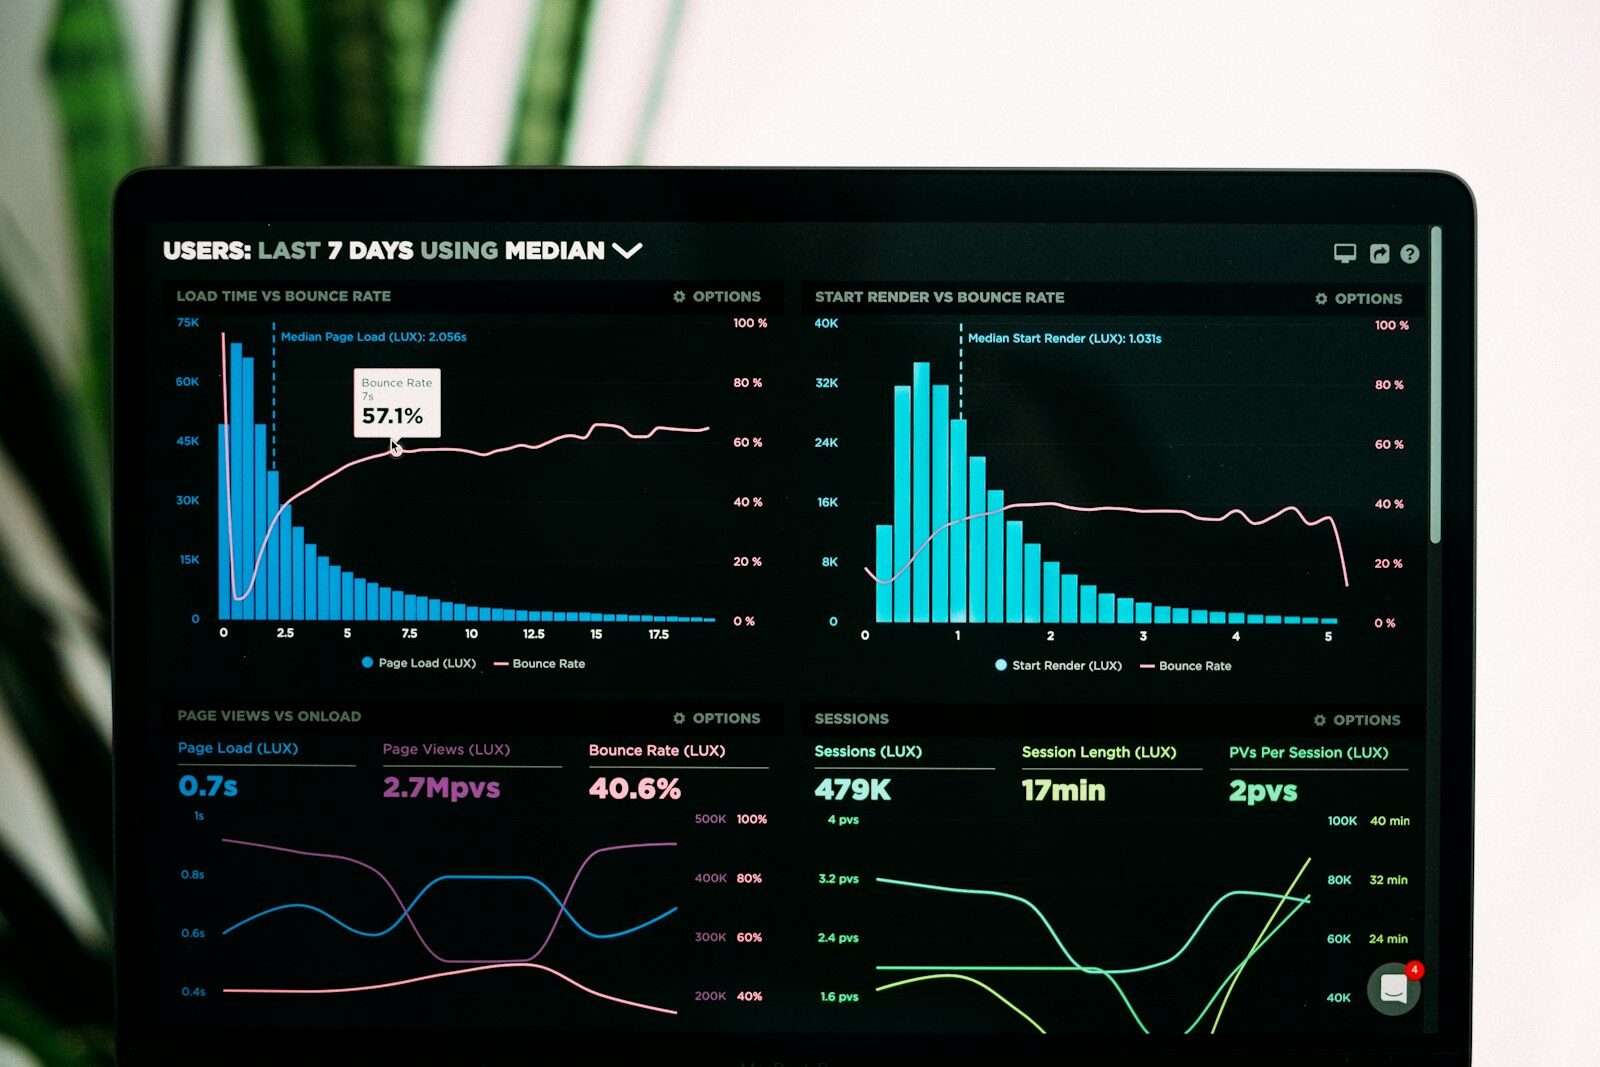
Le dashboard minimum viable : 1 page, 4 graphiques
Pas dix onglets. Une page. Quatre visualisations, refresh quotidien :
- Ligne de tendance : taux de résolution autonome sur 7, 30 et 90 jours. Le pouls de votre agent.
- Histogramme empilé : volume d’interactions par jour, escalades en superposition. Détecte les pics et les jours noirs.
- Big number : coût par interaction du mois courant vs mois précédent, avec une flèche. Trois secondes pour comprendre.
- Heatmap : taux d’erreur et hallucinations semaine par semaine. Les cases rouges sautent aux yeux.
Côté outils :
- Looker Studio (gratuit, intégration Google Sheets, BigQuery, assistant Gemini). Recommandé pour 90 % des cas. Mise en route : une demi-journée.
- Metabase (open source self-hébergé, ou 85 €/mois en cloud). Idéal si vos données sont déjà en SQL.
- Notion ou Airtable (mise à jour manuelle ou via Zapier). Suffisant sous 100 interactions/semaine.
Aucune raison de payer 500 €/mois un outil dédié tant que vous n’avez pas saturé ces options.
Le ROI consolidé et les coûts qu’on oublie
ROI % = (Économies − Coûts) ÷ Coûts × 100. Les benchmarks 2026 donnent un retour moyen de 3,50 € pour chaque euro investi, jusqu’à 8× pour les leaders. L’année 1 plafonne souvent à +40 %, l’année 3 dépasse +120 %.
Mais elle ne dit pas tout. Le vrai piège : compter les économies salariales et oublier les coûts cachés.
- Inference (tokens LLM, peut exploser silencieusement avec le volume)
- Monitoring et observabilité
- Support interne (temps passé à expliquer « pourquoi l’agent a fait ça »)
- Retraining et mises à jour de prompts à chaque nouveau modèle
- QA humain (échantillonnage hebdomadaire non négociable)
- Infrastructure annexe (base vectorielle, logs, stockage)
- Maintien du knowledge base (sans entretien, l’agent régresse en trois mois)
Un ROI honnête intègre tous ces postes. Sans quoi vous célébrez une économie qui n’existe pas. C’est aussi ce que nous regardons dans la grille d’évaluation post-déploiement, au croisement de la sécurité, de la gouvernance et du coût réel.
De la mesure à la confiance
Un agent IA non mesuré finira par dériver. C’est mathématique. Les modèles changent, les usages évoluent, votre knowledge base vieillit. Sans dashboard, vous ne le saurez pas avant que le client ne parte, et il préfère partir plutôt que vous le dire.
Il ne faut pas six mois pour passer de l’angoisse à la confiance. Huit KPIs, quatre graphiques, une page Looker Studio. Une après-midi de mise en route. Et vous récupérez la capacité de décider. Couper, ajuster, étendre. Sereinement.
Un agent IA en production sans dashboard ? Nous proposons un audit d’observabilité court : diagnostic KPIs, angles morts identifiés, plan de remédiation chiffré. Parlons-en.
Restez informé des dernières actualités gratuitement
Automatisation, IA, développement web et stratégie digitale pour PME. Un email par semaine, zéro spam.
Articles similaires
Agent IA : 10 questions pour évaluer sa fiabilité en PME
Votre agent IA se réveille 48 fois par jour, à vos frais
82 %, 65 %, 61 % : la fin de l'angle mort shadow AI